在同一个终端里分屏运行 Ollama 和 SSH 会话
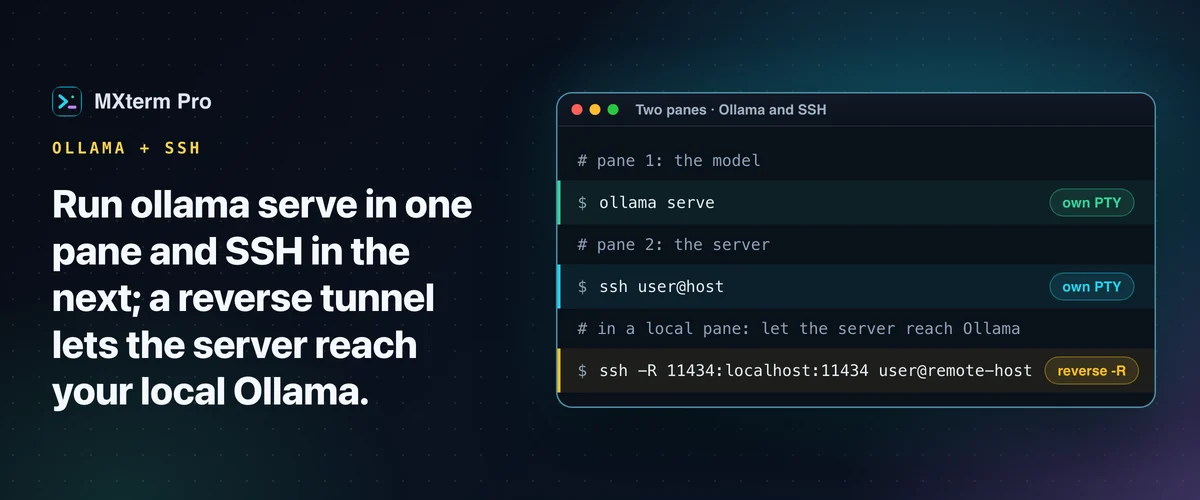
要在终端里同时用 Ollama 和 SSH,就把 ollama serve 放进 MXterm Pro 的一个分屏,SSH 连接放进旁边的分屏。需要多留意的是跨 SSH 连接访问 Ollama,这要用到 Ollama SSH 隧道。两个分屏是各自独立的 PTY,在同一个分屏工作区里。从模型输出切到远程服务器日志,点一下或按个快捷键就行,不用切应用。
分屏布局:一个分屏跑 Ollama,一个分屏跑 SSH
新建工作区,拆成两个分屏,在其中一个里运行 ollama serve。想交互式聊天,就改用 ollama run llama3。要把 SSH 接进这个工作区,可以从 SSH Manager(⇧⌘H)连接,它会打开自己的标签页,再把这个标签页拆开,一半留给 Ollama。也可以直接在分屏里输入 ssh user@host。
两者都是真正的 PTY,各自是独立的操作系统进程。调整其中一个的大小、聚焦或关闭它,都不会影响另一个。
在远程服务器上干活时,盯着 Ollama 的输出很有用:模型加载进度、请求日志、内存警告。要确认 Ollama 还有没有响应、模型加载完没有,不用切到别的终端应用,看旁边的分屏就行。
相关指南在 Mac 的多分屏终端里运行 Cursor CLI(cursor-agent)从远程服务器访问本机的 Ollama
Ollama 默认监听 127.0.0.1:11434,只接受本机连接。假设远程机器上的脚本要调用你 Mac 上 Ollama 的 /api/generate。那台服务器的 localhost 不是你 Mac 的 localhost,没有隧道,请求就会失败。
改成 OLLAMA_HOST=0.0.0.0 绑定,会暴露一个没有任何认证的 API,所以默认用隧道更稳妥。
办法是标准的反向 SSH 隧道,不是 MXterm Pro 额外加的功能:ssh -R 11434:localhost:11434 user@remote-host。它把远程服务器的 11434 端口转发回你 Mac 上的 Ollama。之后在远程服务器上运行 curl http://localhost:11434/api/generate,就能访问你本机的模型。
远程 sshd 必须允许 TCP 转发,而且这个端口只绑定在远程主机的本机回环地址上。MXterm Pro 的 SSH 隧道管理器只能添加本地(-L)转发,所以这条 ssh 命令要自己在 Mac 本地的分屏里输入。它是普通的 SSH 端口转发,从哪个应用发起 SSH 都能用。
反过来的情况,Ollama 跑在远程 GPU 机器上,你想从 Mac 查询它,就用普通的正向隧道:ssh -L 11434:localhost:11434 user@gpu-host。之后在本地运行 curl http://localhost:11434/...,就能访问远程模型。
分屏之间的内存、GPU 和资源争用
ollama ps 会列出当前已加载的模型和各自占用的内存,在另一个分屏里就能快速查看。已加载的模型会一直留在内存里,直到 Ollama 卸载它,默认是最后一次请求后 5 分钟。如果用了 Metal 或 CUDA 加速,它也会留在显存里。OLLAMA_KEEP_ALIVE=10m ollama serve 可以改这个时间。
资源争用是分屏容易出问题的地方。MXterm Pro 不会给分屏里的进程设沙箱,也不限制它们能用多少资源,所以一个终端分屏占多少资源,取决于背后的 shell。
再加第三个分屏,跑一个正在编译大型项目的编程 Agent,三个分屏就共用同一台 Mac 的内存、CPU 和 GPU。内存有限的机器上,这个共同的上限才是实际瓶颈,和分屏或 SSH 本身无关。
如果 ollama serve 报 “address already in use” 错误,拒绝启动,说明已经有进程绑定了 11434 端口。常见原因是之前的某个分屏,或者你装了单独的 Ollama 菜单栏应用。先运行 lsof -i :11434 看是谁占着,再决定杀掉它,还是直接用已在运行的实例。
在同一个工作区加入 Command Recipes 和编程 Agent
MXterm Pro 的 Command Recipes(Cmd+J)和 Ollama 正在提供的模型没有关系。它根本不用模型,只是一组按关键词匹配的现成 Linux 命令。也没有设置能让它指向 Ollama。
它的用处更窄,主要在 SSH 连到 Linux 服务器的那个分屏里。不用查参数,就能调出现成的命令:哪些进程占内存最多、系统日志最后 50 行、谁绑定了 11434 端口。这些都是 Linux 命令,所以内存和日志相关的命令在本地 macOS 分屏里不能原样运行。没有覆盖 GPU 显存的命令。
如果有编程 Agent(Claude Code、Codex、Cursor)在生成调用本地模型 API 的代码,就让它跑在第三个分屏里。Agent、模型和要部署的服务器,都留在同一个工作区里看得见。
在创建工作区页面里打开为每个功能使用独立的 git worktree,当文件夹是 git 仓库时,每个 Agent 分屏会在自己的分支上得到独立的工作目录,路径是 <repo>/.worktrees/<slug>。这个选项默认关闭。它能降低冲突概率,即两个 Agent 在编辑中途改到同一批文件的情况。
费用:Free 和 Pro 的区别
这些都不需要 Pro。默认情况下,MXterm Pro 的 Free 套餐支持不限数量的终端分屏、最多 5 台已保存的 SSH 主机和 1 台已保存的 MXterm Host,并带完整的 SFTP 图形界面文件管理。一个 Ollama 分屏加一个 SSH 分屏就是两个分屏,Command Recipes 弹窗一个都不占:对这个具体的工作流来说,离任何上限都还远。
只有当你同时管理超过 5 台远程主机时,上限才会碍事。Pro 取消了 SSH 主机的数量限制:已保存的 SSH 主机不限数量。
iTerm2 + tmux、Warp 和纯 SSH 客户端
iTerm2 本来就有真正的分屏,不少开发者在一个 iTerm2 分屏里跑 ollama serve,在另一个里连 SSH。你也可以把 Ollama 放在远程机器的 tmux 会话里,SSH 断开后它还在。只要分屏就够用,这套做法很稳。
iTerm2 成熟、可脚本化、免费。它的 Snippets 功能只会重发你自己保存的字符串,而 Command Recipes 是一组现成的 Linux 命令,用来做会话周边的检查。如果你对同一个仓库再跑一个 AI 编程 Agent,它也没有内置的办法隔离第二个 Agent 的工作目录。
Warp 有自己的 AI 功能,围绕命令块组织,所以是另一种工作流,不是缺了什么。Termius 和 MobaXterm 是成熟的 SSH/SFTP 客户端,主机管理做得扎实,如果 SSH 就是全部需求,它们很合适。
在 MXterm Pro 里,Ollama、SSH 和 Agent 的分屏放在同一个工作区,另外还有 Command Recipes,以及给每个 Agent 单独用的 worktree。
多分屏 SSH、Command Recipes(Cmd+J)和多 Agent 的 Control Room (原 War Room):先免费用。
常见问题
没有。MXterm Pro 不会直接调用 Ollama 的 API,只是像运行其他命令一样,在终端分屏里运行 ollama。好处是这个分屏就在 SSH 和 Agent 分屏旁边,而不是有专门的 Ollama 功能。
开一条反向 SSH 隧道:ssh -R 11434:localhost:11434 user@remote-host。它把远程的 11434 端口转发回你的 Mac,所以在远程机器上运行 curl http://localhost:11434/api/generate 就能访问本机的模型。MXterm Pro 内置的转发只支持本地(-L),所以要在分屏里手动输入。远程 sshd 必须允许 TCP 转发,这个端口也只绑定在远程主机的本机回环地址上。
不会直接抢。SSH 是网络 I/O,不是计算,所以空闲的 SSH 分屏不会占用已加载 Ollama 模型的内存或 GPU。不过所有分屏共用同一台 Mac 的总内存、CPU 和 GPU,因为 MXterm Pro 不会给分屏里的进程设沙箱。第三个分屏如果很重,比如编程 Agent 在编译东西,仍然可能拖慢整体。
已经有进程绑定了 11434 端口,常见的是之前的某个分屏,或者你装了单独的 Ollama 菜单栏应用。运行 lsof -i :11434 看是谁占着。然后要么直接用那个实例,要么先停掉它再启动新的。
可以。分屏彼此独立。关闭 SSH 会话或 Agent 分屏,不会影响另一个运行 Ollama 的分屏。